Mac · SoMark OXR 在本机运行 · 表格、公式、扫描件 · 命令行
Leaflift:在自己的 Mac 上把 PDF 转成 Markdown
拖入一个 PDF,或者一整个文件夹,得到可以直接贴进知识库、笔记软件或 AI 对话的 Markdown:表格保留合并单元格,公式写成 LaTeX,代码还是代码,扫描页也能识别。模型在你的 Mac 上运行,文档不会离开这台电脑。
US$6.99 一次买断 · 含免费版
版本 1.0.1 · macOS 14 Sonoma 或更高,Apple 芯片 · 安装包 54 MB,首次启动另需下载一次 1.6 GB 的模型
一次买断 · 包含全部 1.x 更新 · 14 天无理由退款
你的授权码
打开 Leaflift → 偏好设置 → 购买 → 授权码,粘贴整行。请另外保存一份:授权码离线可用,适用于你自己的所有 Mac 和全部 1.x 版本。
能得到什么
Leaflift 为每个 PDF 写一个 .md 文件,放在 PDF 旁边或你指定的文件夹里,另有一个文件夹存放裁出来的图片。页面上的各部分是这样处理的:
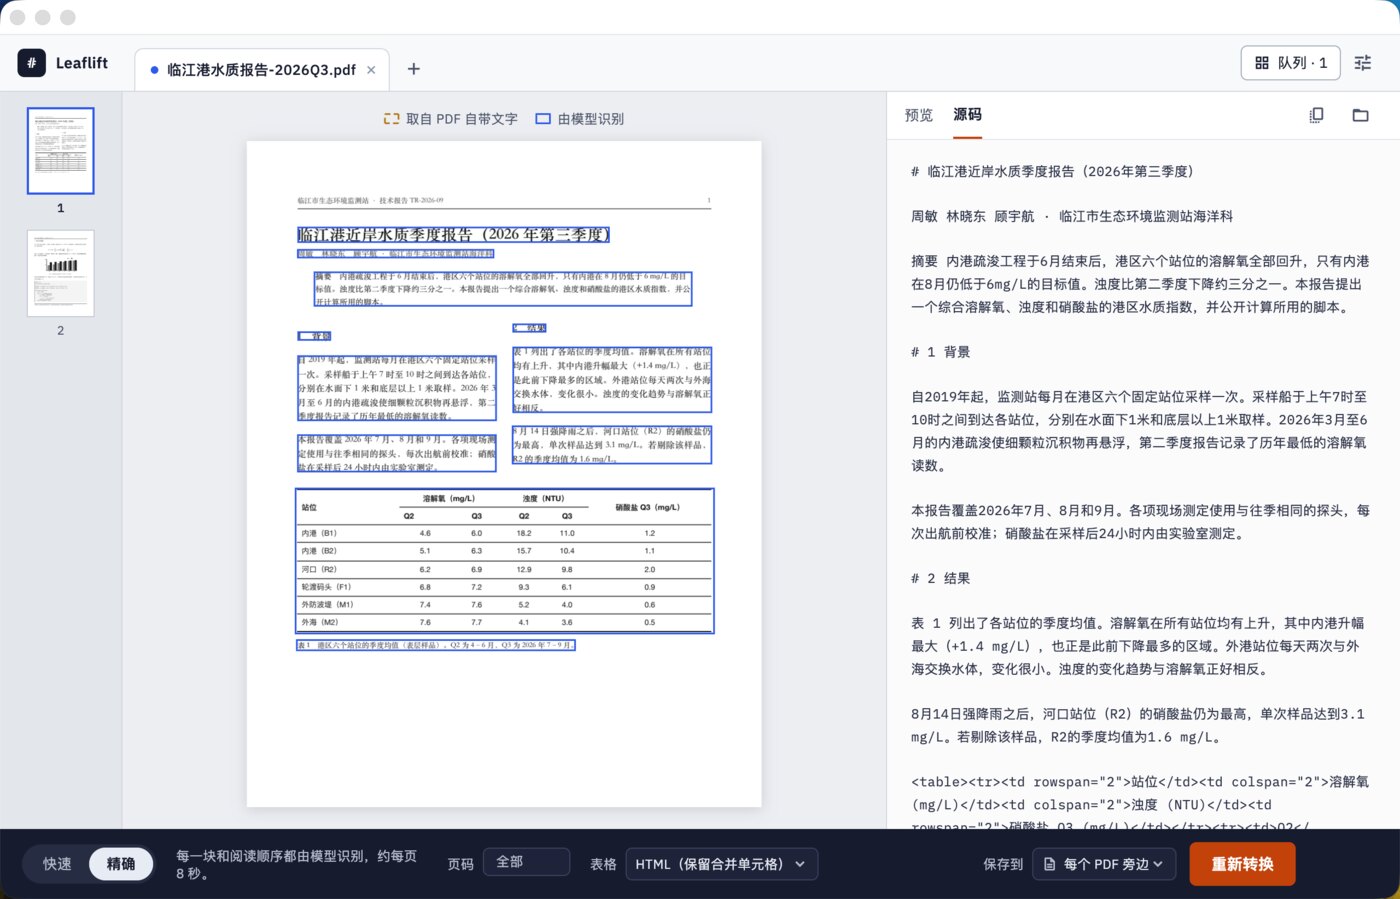
- 表格输出为保留合并单元格的 HTML 表格(Markdown 自带的表格表达不了合并单元格),也可以选普通 Markdown 表格。
- 公式转成 LaTeX:独立公式用
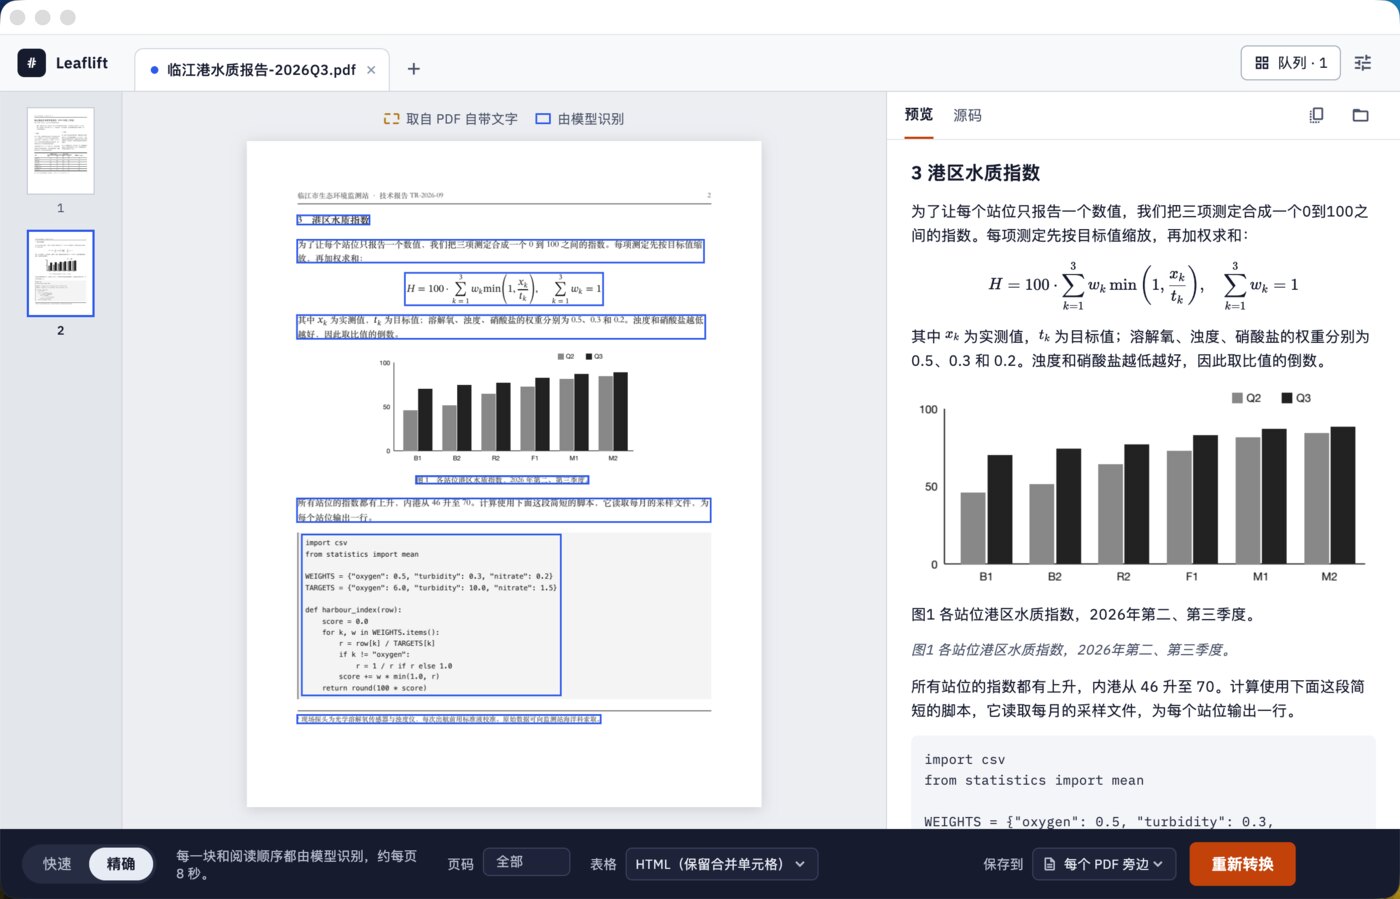
$$…$$,行内公式用$…$,公式编号放在公式外面。 - 扫描页和拍照得到的文档,PDF 里一个字都没有,模型照样像普通页面一样识别。
- 代码保留缩进放进代码块,标题变成
#标题,图片存成 PNG 并在文中链接,每页重复的页眉页脚会去掉。 - 阅读顺序在精确模式下由模型判断,双栏论文先读左栏、再读右栏。
基于 SoMark OXR:当前最强的文档解析模型之一
Leaflift 的识别由 OXR-1.0 完成,这是 SoMark 开源的文档解析模型,13 亿参数。它逐块读取页面上的内容(段落、表格、公式),写出文字,再决定各块的阅读顺序。SoMark 公布的结果显示,它在下面三个公开的文档解析基准上都排名第一:
| 基准(总分) | OXR-1.0 | SoMark 列出的第二名 |
|---|---|---|
| olmOCR-Bench | 87.84 | 87.60(Infinity-Parser2-Pro) |
| OmniDocBench | 97.18 | 96.91(TeleOCR) |
| DocParsingBench | 87.76 | 85.17(PaddleOCR-VL-1.6) |
数据来自 SoMark 公布的基准页面,2026 年 10 月 29 日查阅;SoMark 是在自己的 GPU 服务器上以全精度跑的。我们没有用 Leaflift 重跑这些基准。
SoMark 用数据中心 GPU 提供 OXR 服务,我们让它在 Mac 上跑了起来:
- 自己的推理引擎。Leaflift 通过 llama.cpp 在 Mac 的 GPU(Metal)上运行 8 位量化的 OXR,版面分析用 ONNX Runtime 跑 D-FINE 模型,PDF 本身由 PDFium 处理,全部在 App 里完成。
- 与原版逐字对照过。在我们的测试页上用 SoMark 自己的流程跑,8 位模型的输出与 SoMark 全精度模型在 213 个块中有 202 个逐字相同;图像特征与全精度的余弦相似度 ≥ 0.9997,比 SoMark 自己的 bf16 服务还接近全精度。
- 两种模式。精确模式让模型识别每一个块并决定阅读顺序,与 SoMark 官方流程一致,M2 Max 上约每页 8 秒;快速模式能用 PDF 自带文字的地方直接用,只把表格、公式、代码和扫描页交给模型,约每页 3 秒。App 里蓝色和橙色的边框标出每个块用的是哪一种。
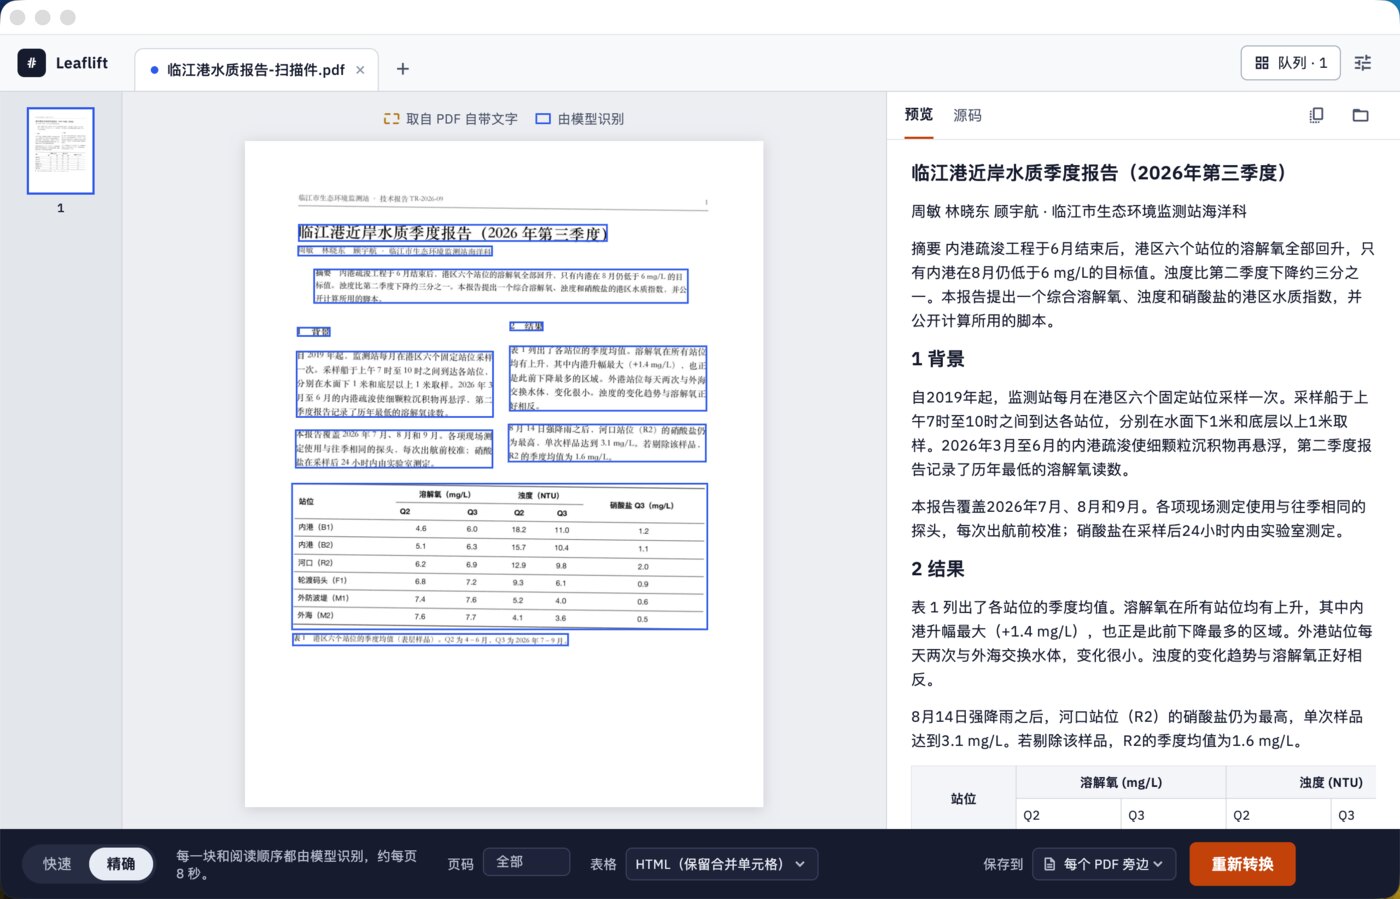
一页完全没有文字层的扫描件:每个块都是蓝框,表示都由模型识别,表格也不例外。
整个文件夹一次转完
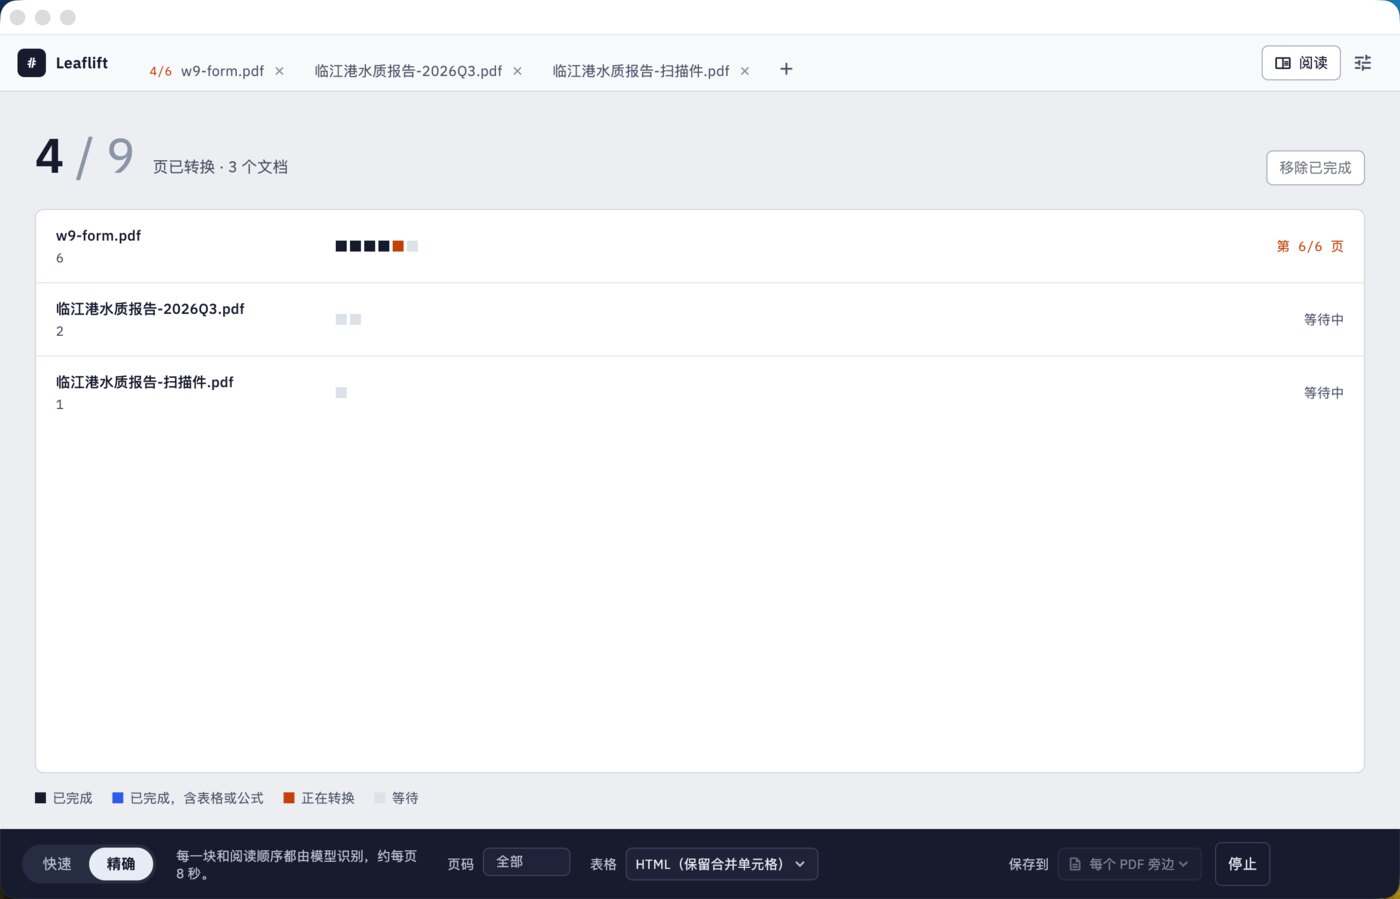
把一个或几个文件夹拖进窗口,Leaflift 会依次转换里面的每个 PDF,队列里用小方格显示每一页的进度。某个文档失败不影响其他文档,加密的 PDF 会等你输入密码,随时可以停止。识别过的页会保留下来,所以同一个 PDF 再转一次(停止之后,或者换了表格格式)只会识别新的页。
命令行与 AI 助手
Leaflift 自带命令行工具 leaflift,与 App 用同一个引擎、同一套模型和设置。可以在终端里转换一个文件或一整棵文件夹树,写进脚本,或者交给能在你 Mac 上运行命令的 AI 助手,比如 Claude Code 或 Codex。「把 Papers 文件夹里的 PDF 转成 Markdown,再逐个总结」就是它替你跑的一条命令,而文档依然不会离开你的电脑。
--json 转换两个 PDF,然后看 Markdown 的前几行。leaflift report.pdf # 在旁边生成 report.md 和 report_images/
leaflift ~/Papers -r -o ~/Markdown --json # 整棵文件夹树,每个文件一行 JSON
leaflift scan.pdf --mode accurate --tables markdown
leaflift thesis.pdf --pages 1-12 --stdout | pbcopy- 为脚本和 AI 代理设计。
--json为每个文件输出一行(输入、输出、页数、耗时),最后一行是汇总;进度写到 stderr;退出码固定。没有任何交互提问,不会卡在等待输入上。 - 可以放心重跑。已经有 Markdown 的文件默认跳过(加
--overwrite才重转),识别过的页会复用,中断的批量任务从停下的地方接着做。 - App 的选项都有。快速或精确模式、页码范围、HTML 或 Markdown 表格、是否保存图片、是否保留页眉页脚,输出 Markdown 或带每个块类型、位置和来源的 JSON。
- 不用另外安装。工具就在 App 里。偏好设置 → 命令行 → 安装 给出一行命令,粘贴到终端执行一次之后,任何终端窗口里都能用
leaflift;也可以直接调用/Applications/Leaflift.app/Contents/Helpers/leaflift。
给 AI 助手的提示词
把下面这段粘贴到 Claude Code、Codex 或其他能用终端的助手里,再写上你要做的事。
我的 Mac 上装了 Leaflift,它用 SoMark OXR 模型离线把 PDF 转成 Markdown,自带命令行工具:
"/Applications/Leaflift.app/Contents/Helpers/leaflift"
(如果我装过,PATH 里也能直接用 leaflift)。先运行 --help。用法:
  leaflift <文件或文件夹> [-r] [-o <目录>] [--mode fast|accurate] [--pages 1-3,7] [--tables html|markdown] [--json]
  leaflift models                         模型放在哪里、是否完整
不加 -o 时,在每个 PDF 旁边写 <名字>.md 和 <名字>_images/。已存在的输出会跳过,除非我要求加 --overwrite。
--mode fast(默认)尽量用 PDF 自带的文字;--mode accurate 让模型识别全部内容,复杂版面和扫描件效果更好,约每页 8 秒。
表格默认是 HTML(保留合并单元格),加 --tables markdown 则是 Markdown 表格;公式是 LaTeX。
加 --json 时,stdout 每个文件一行 JSON({"type":"file"|"skipped"|"error", "input", "output", "pages", "seconds", …}),最后一行是 {"type":"summary"};进度写到 stderr。
退出码:0 全部转换或跳过,1 部分文件失败(其余照常转换),2 参数错误或没找到 PDF,3 需要 Leaflift 授权,4 模型缺失(先打开一次 App 下载模型),130 被中断。
遇到退出码 3 或 4 时请告诉我,不要自己绕过去。不要删除或移动我的 PDF。
我的任务是:
命令行属于授权版。没有授权时,leaflift 可以显示帮助和模型状态,开始转换前就以退出码 3 停下,AI 助手能据此告诉你原因。
免费版与授权
下载的就是完整的 App。没有授权时,每个 PDF 只转换第 1–20 页,一次一个 PDF,足够用你自己的文档确认效果。授权后没有这些限制。
| 免费版 | 授权版 | |
|---|---|---|
| 每个 PDF 的页数 | 第 1–20 页 | 全部 |
| 保留合并单元格的表格、LaTeX 公式、代码、图片 | ✓ | ✓ |
| 扫描页;快速与精确两种模式 | ✓ | ✓ |
| 整个文件夹一次转完 | — | ✓ |
| 给脚本和 AI 助手用的命令行 | — | ✓ |
| 更新 | ✓ | 全部 1.x 更新 |
| 价格 | 免费 | US$6.99,一次买断 |
文档留在你的 Mac 上
不上传、不用注册账号、不订阅。Leaflift 从不把你的 PDF、其中的文字或文件名发送到任何地方。它只有两种网络请求:首次启动时从我们的下载服务器下载一次 1.6 GB 的模型(如果你手上已经有模型文件,可以直接指定那个文件夹,跳过下载);以及每天检查一次更新,从 swordfishsoft.org 下载新版本列表和已退款订单列表,每个人拿到的都是同样的文件。检查更新可以在设置里关掉。转换本身完全不需要联网。详见我们的隐私政策。
购买流程
- 先下载免费版试用。打开磁盘映像,把 Leaflift 拖进「应用程序」,首次启动时让它下载模型,然后转换一份你自己的 PDF。
- 在本页购买授权。结账由我们的经销商 Paddle 处理,可以用银行卡、PayPal 或结账页显示的其他方式付款,按地区加收相应的税费。
- 复制授权码。付款成功后授权码立即显示在本页,同时发到你付款用的邮箱。粘贴到 Leaflift → 偏好设置 → 购买,限制随即解除。
授权码丢了?用付款邮箱发信到 [email protected],我们会重新发给你。
常见问题
和 Marker、MinerU、Docling 有什么不同?
那些是免费的开发者工具:要装 Python、机器学习环境,往往还要装 GPU 驱动,再在终端里运行。Leaflift 是拖进「应用程序」就能用的 App,有窗口可以逐页对照原文和 Markdown,需要时也有命令行。它用的是更新的 OXR 模型,SoMark 公布的成绩领先于这些工具所用的模型。
和 Mathpix、或者把 PDF 传给 ChatGPT 相比呢?
这两种方式都要把文档发到别人的服务器上,Mathpix 还是按页计数的月度订阅。Leaflift 在你的 Mac 上读 PDF,页数不限,一次买断。合同、病历、未发表的论文,以及任何你不想上传的文档,这一点都很重要。
AI 助手能用它吗?
能,这正是命令行的用途。在你电脑上运行的助手,比如 Claude Code 或 Codex,可以调用 leaflift 并读取它写出的 Markdown。助手拿到的是文字而不是 PDF,Leaflift 这一侧也不经过任何云端。
哪些 Mac 能用?
Apple 芯片(M1 及以后)、macOS 14 Sonoma 或更高版本的 Mac。不支持 Intel 芯片的 Mac。本页的速度是在 M2 Max 上测的,你的 Mac 有多快,用免费版试一下就知道。
有 Windows 版吗?
暂时没有,Leaflift 目前只支持 Mac。想要 Windows 版的人多了我们就会做,到时同一个授权可以直接用。需要的话请写信到 [email protected] 告诉我们。
中文、日文等文档能处理吗?
OXR 对中英文混排的文档效果很好,表格和公式也一样;本页的截图就是一份中文报告。其他文字取决于模型的训练数据。建议先用免费版试试你自己的文档。
一份文档要多久?
在 M2 Max 上,快速模式约每页 3 秒,精确模式约每页 8 秒;整页都是一张大表的页面可能要 10 秒。较慢的 Mac 会更久。Leaflift 会按你选的模式显示预计速度,你也可以只转需要的页。
macOS 问我是否确定要打开,这正常吗?
正常。从网站下载的 App 第一次打开时,macOS 都会问一次。请确认提示里写着 Apple 已检查过、未发现恶意软件,然后点「打开」:这说明 App 用我们的 Apple Developer ID 签名并经过 Apple 公证。如果提示写的是 Apple 无法验证这个 App,而且没有「打开」按钮,请不要打开,从本页重新下载;如果还是这样,请发邮件告诉我们。
如果用起来不满意?
每笔购买都有 14 天无理由退款。
销售方:重庆剑鱼科技有限公司(Chongqing Swordfish Technology Co., Ltd.,品牌 SwordFishSoft)。订单由我们的在线经销商 Paddle.com 处理,Paddle.com 是所有订单的记录商户(Merchant of Record)。条款 · 退款政策 · 隐私。Powered by SoMark OXR:OXR-1.0 © SoMark,依 OXR Open Source License(Apache License 2.0 加附加条款)使用,Leaflift 的模型文件是它的 8 位量化转换版本。D-FINE(Apache-2.0)、llama.cpp(MIT)、PDFium(BSD-3-Clause)。截图中的报告是为本页撰写的,W-9 表格是美国政府作品,属于公有领域。