在浏览器里抠图:4 个开源模型在 WebGPU 与 WebAssembly 上的实测对比
想做「不上传也能抠图」,模型就得在用户自己的电脑上跑。能在 Python 里抠得好的开源模型不少,但同时满足三个条件的就少多了:有能在浏览器里正确运行的 ONNX 文件,下载体积说得过去,许可证允许商用。
我们把过了这三道筛子的四个候选,放在同一组照片上,在同一个无头 Chrome 里分别走 WebGPU 和 WebAssembly 跑了一遍。本文给出实测数字和并排的抠图结果,也说明那些有名的方案为什么没进名单。我们给图片去背景工具选模型时,先在一张照片上做过同样的比较,这次是更完整的重测。
先看结论
| 模型(Hugging Face 仓库) | 许可证 | 下载体积 | WebGPU 每张 | CPU(WASM)每张 | 擅长 | 失手的地方 |
|---|---|---|---|---|---|---|
BiRefNet-lite,512² 导出studioludens/birefnet-lite-512 | MIT | 98 MB(fp16) 192 MB(fp32,CPU 用) | 1.1 秒 | 1.6 秒 | 商品、宠物、人像,四个里最稳定 | 极细的毛(胡须);会丢掉被画面边缘切掉一半的次要主体 |
ISNet general,int8xrds/isnet-general-onnx-int8 | MIT | 44 MB | 0.32 秒 | 2.2 秒 | GPU 上最快的通用模型;宁多勿少 | 留下半透明的雾状残影,桌子、道具也一起抠出来 |
BEN2onnx-community/BEN2-ONNX | MIT | 219 MB(只有 fp16) | 0.98 秒 | 14.1 秒 | 单一主体很干净 | 我们那张合影:出现空洞和碎片;CPU 上太慢 |
MODNetXenova/modnet | Apache-2.0 | 26 MB | 0.14 秒 | 0.44 秒 | 人和动物,非常快 | 人和动物以外的东西:茶壶被切成了碎片 |
耗时是四张照片(下面三张加一张合影)每张的中位数,先用一张图热身再计时,包含 JPEG 解码和管线自带的前后处理。环境:Apple M2 Max,无头 Chromium 153,Transformers.js 4.2.0 + onnxruntime-web 1.26.0-dev,WebAssembly 12 线程,2026-09-22 实测。
并排看
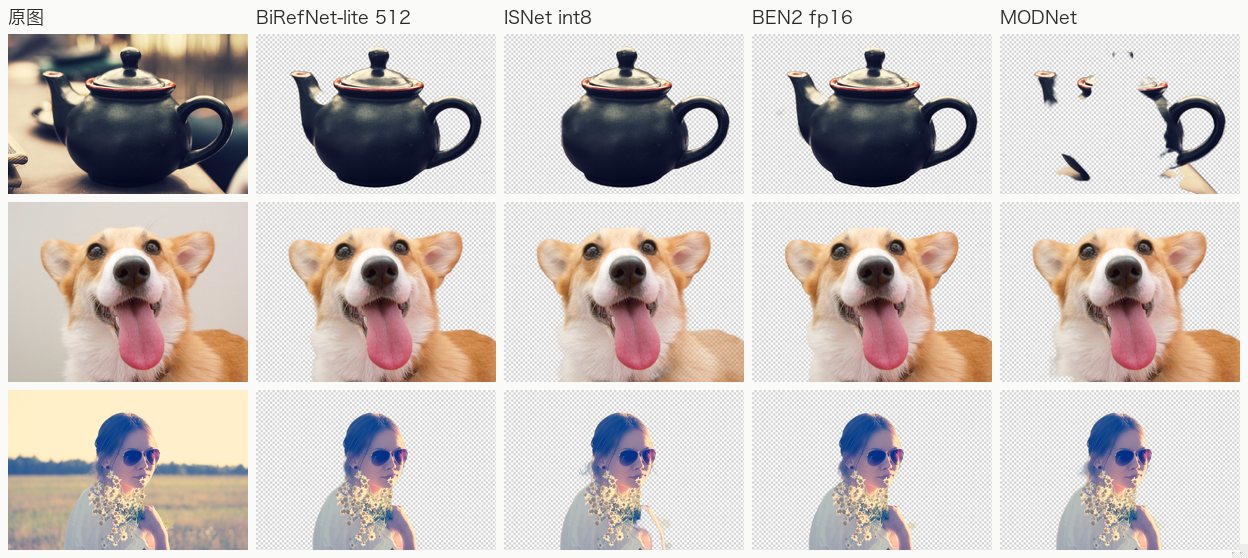
缩略图大小下,四个里有三个在三张照片上都还行,MODNet 的茶壶一眼就能看出失败了。差别要放大才看得出来:
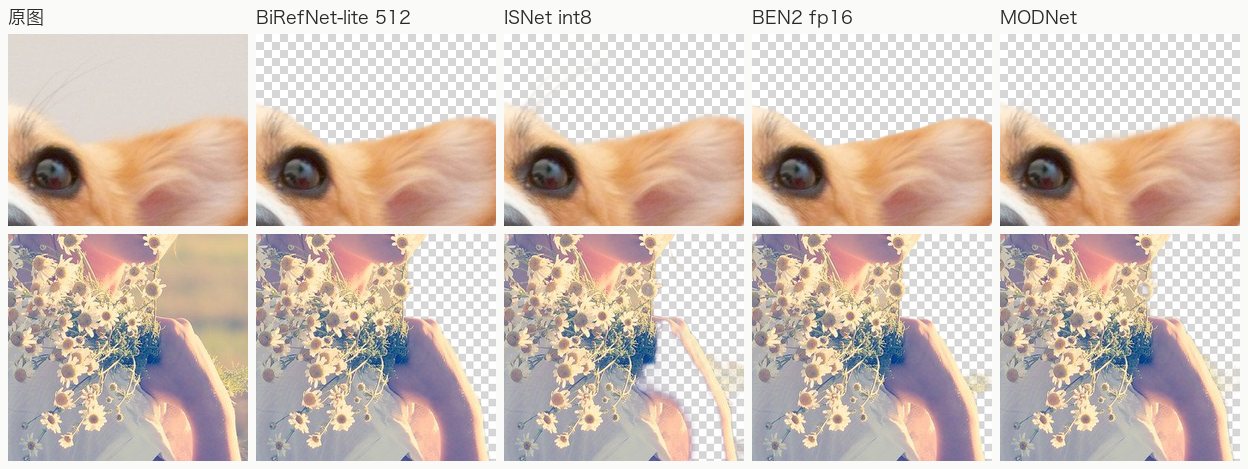
- 胡须:四个模型都没保住柯基的胡须。在这种体量的模型上,一两个像素宽的细丝基本都会丢。如果胡须、碎发对你很重要,得准备手动修。
- 花束:四个都保住了雏菊,连花茎都在,比我们预想的好。ISNet 还在手臂旁边留了一块发白的半透明背景。这是它的一贯倾向:拿不准的区域宁可留着,也不切掉。
- 茶壶:深色釉面的器物配上明亮虚化的窗光,是小型分割模型的经典难题。BiRefNet、ISNet、BEN2 都抠对了。ISNet 把壶嘴尖削掉了一点(前景占比 35.4%,另外两个约 38%)。MODNet 只剩碎片(12%),因为它是为人像抠图训练的,不是通用物体。
那张合影
我们还跑了第四张更难的照片:户外几个人围着一张摆满书的桌子,最左边还有一个人被画面切掉了一半。因为没能核实这张图的许可证,这里不展示,但数字已经说明问题:同一张图,前景占比从 18.7%(BEN2)到 39.8%(ISNet)不等。
- ISNet 所有人都留下了,折叠桌和书也一起留下,周围还带一圈雾。
- BiRefNet-lite 把中间两个人抠得很干净,桌子去掉了,但左边那个只露出一半的人也被去掉了。
- BEN2 主要人物很干净,第二个人身上却有空洞,书本变成了半透明的碎片。
- MODNet 留下了人,外加一些零散的碎块。
「什么算主体」本身就是个判断题,没有哪个模型能对所有用途都判断对。这也是为什么好用的抠图工具应该让你在下载前先看清蒙版。
WebGPU 与 WebAssembly:结果一样,速度不同
每个模型在两个后端上、每张照片的前景占比,差异都在 0.2 个百分点以内。这让人放心,因为并不总是这样(见我们写的在 WebGPU 上静默输出废图的模型)。速度就是另一回事了:
- ISNet int8 在 WebGPU 上比 CPU 快 7 倍。
- BEN2 在 WebGPU 上快 14 倍。CPU 上每张 14 秒,对浏览器里没有可用 GPU 的用户来说基本没法用。
- BiRefNet-lite 在 WebGPU 上只快 1.5 倍。CPU 路径用的是 fp32 权重(192 MB),WebGPU 用的是体积减半的 fp16。
- MODNet 在哪都快:26 MB,CPU 上也不到半秒。
写这篇文章时,我们的工具把 WebAssembly 限制在 4 线程,免得页面其余部分卡顿。在那个设置下的验收实测中,一张 1024×683 的照片,BiRefNet-lite 在 CPU 上用 1.8 秒,WebGPU 上 1.0 秒。2026 年 9 月 25 日更新:本站已不再发送跨源隔离的响应头,CPU 路径改为单线程,同一张照片在 CPU 上要 5.3 秒;WebGPU 不受影响。
怎么绕开 512×512 的蒙版
模型在 512×512 分辨率下预测蒙版,并不意味着你拿到的结果只有 512 像素。下面是我们的工具对 BiRefNet-lite 的输出做的处理,其中没有哪一步是这个模型专属的。
- 只从模型那里取 alpha 通道。蒙版用浏览器画布的平滑插值放大到照片的原始尺寸,再作用到原图像素上。4000 像素宽的照片,输出仍是 4000 像素宽;低分辨率预测的只是蒙版的边缘,颜色信息一点没丢。
- 可选 0–3 像素的羽化。512 的蒙版放大到 4000 像素,斜边上会有细小的台阶。只对 alpha 做一次轻微的方框模糊,就能把台阶抹掉,主体本身不会变软。它是个滑块,默认关闭,因为硬边的商品照通常不需要。
- 内存不足不会直接失败。走 WebAssembly 时,特别大的照片可能触发
std::bad_alloc。这时工具会把输入缩到约 400 万像素再跑一次,然后把得到的蒙版放大回原尺寸。你拿到的仍是全分辨率的抠图,只是边缘稍软,页面上也会提示发生了这一步。 - 同一张照片,输出同一个文件。同一张图跑两次,得到的 PNG 逐字节相同。想判断页面改动之后效果是变好还是变差时,这一点很重要。
这些处理都不会让蒙版比模型预测的更精细,胡须该丢还是丢。它们做的是让图像的其余部分保持原画质,模型分辨率只影响边缘,不影响整张图。
没进名单的,以及原因
- BRIA RMBG 1.4 / 2.0:效果好,但许可证是非商用,转传这些权重的镜像仓库也就一并排除了。
- 原生 1024×1024 的 BiRefNet-lite(
onnx-community/BiRefNet_lite):WebGPU fp16 报 shader 错误,WebAssembly fp32 内存不足(std::bad_alloc)。是 512×512 的重导出让 BiRefNet 在浏览器里变得可用。代价是蒙版在 512 分辨率下预测再放大,最细的边缘会比 1024 模型软一些。完整版 BiRefNet 我们没测,fp16 约 490 MB,超出了免费页面的体积预算。 onnx-community/ISNet-ONNX里的 ISNet:这个仓库标的是 AGPL-3.0。同一份 ISNet-general 权重在 IMG.LY 的发布里是 MIT,我们测的 int8 文件就源自那里,所以用了它。rembg 里叫isnet-general-use的,也是这个模型家族。- rembg 本身:rembg 是个 Python 包,不是模型。它默认的 U²-Net,我们在 Hugging Face 上没找到有人维护的 ONNX 仓库可测。
该选哪个
- 通用的「一键去背景」(商品、宠物、人像都要能处理):选 BiRefNet-lite 512。按我们的判断,它在四张照片上都不是最差的,两个后端结果也一致。我们的工具用的就是它。
- 最看重速度、且能假定用户有 WebGPU:选 ISNet int8,三分之一秒,44 MB,但要准备好清理多抠出来的区域。
- 只处理人或宠物:MODNet 又小又快,人像没问题,别拿它抠物体。
- BEN2:简单主体很干净,但 219 MB、CPU 上每张 14 秒,放在一个谁都可能打开的网页上,我们觉得不划算。
怎么复现
每个「模型 × 后端」组合,都通过 Transformers.js 的 background-removal 管线只加载一次:先用一张图热身,再逐张计时并保存 RGBA 结果。前景占比是 alpha 大于 127 的像素比例。WebGPU 和 WebAssembly 两趟共用一个浏览器配置目录,每个文件只下载一次。脚本是 60 行左右的 Playwright 加一个小 HTML 页面,唯一的非默认设置是:BEN2 的 fp16 图在 WebAssembly 上要用 graphOptimizationLevel: 'basic'。想要脚本的话,来信即可。
文中提到的工具: 图片去背景:免费出原分辨率,全程在你的浏览器里完成