不报错,但输出是废的:把 ONNX 模型搬上 WebGPU 时遇到的静默故障
我们已经上线了 11 个在浏览器里跑开源 ONNX 模型的工具,用的是 ONNX Runtime Web:有 WebGPU 就走 WebGPU,没有就降级到多线程 WebAssembly。模型加载失败的那种故障很好对付:有堆栈,控制台一行红字,错误信息拿去一搜就有线索,通常一个下午就能解决。
真正费事的是另一种:session.run() 正常返回,输出张量形状也对,里面的数却是错的。这篇记录我们遇到的四个这样的案例:怎么发现的,怎么一步步定位的,以及它们让每个工具现在都多了哪些检查。
下文所有结果的环境:Transformers.js 4.2.0,onnxruntime-web 1.26.0-dev(20260416),WebGPU 走 JSEP 后端;Apple M2 Max,无头 Chromium 153,启动参数 --enable-unsafe-webgpu --use-angle=metal;WebAssembly 除特别说明外用 4 线程。这些结论只对这个版本和这台机器负责。换一块 GPU、换一个更新的 ORT,结果都可能不同,有些问题可能已经修了。
一、超过 352×352 就变黑的超分模型
给图片放大工具选型时,我们测了 fp32 的 Swin2SR(realworld,4 倍)。探针每次只做一次前向,记录每个输出的逐通道均值、精确为 0 的像素占比和 NaN 占比。放大不怎么改变整体亮度,所以输入输出的均值应该很接近。同一张蜜蜂照片、不同分块尺寸下,WebGPU 返回的是:
| 分块(宽×高) | 输入均值 | 输出均值 | 零值占比 | 结论 |
|---|---|---|---|---|
| 352×352 | 0.324 | 0.321 | 0% | 正确 |
| 384×352 | — | 0.305 | 4.2% | 有空洞 |
| 384×384 | 0.329 | 0.052 | 0% | 几乎全黑 |
| 512×384 | 0.334 | 0.053 | 0% | 几乎全黑 |
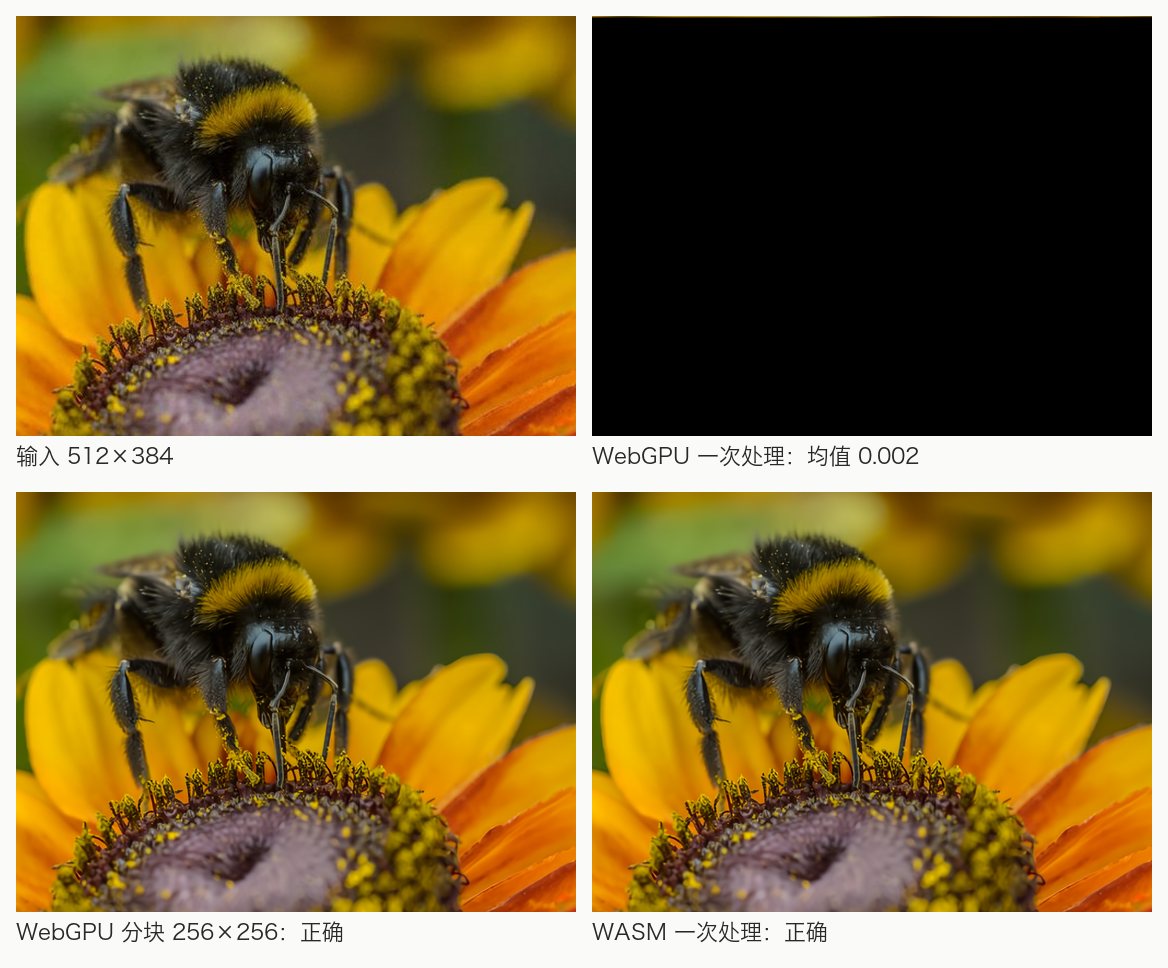
单次前向超过约 12.4 万像素就是一道悬崖:悬崖下方紧挨着一段「局部输出精确为 0」的过渡区,再往上整张图塌成近乎全黑。所有尺寸都不抛异常。一张 400×400 的纯色徽标一次性处理,输出的红色通道均值是 0.003,输入是 0.554;同一张图切成小块处理就正确。WebAssembly 后端没有这个问题:512×384 正常,到 512×512 则是明明白白地报 std::bad_alloc。
fp16 导出更糟,小块也不行:一个 192×192 的块,红色通道输入 0.406、输出 0.037,绿色通道输入 0.387、输出 −0.214。量化版本也试了:同样的分块下,q4 在 WebGPU 上比 fp32 慢 5 倍左右,int8 在 WebAssembly 上直接内存不足。这个模型唯一能用的,就是 54 MB 的 fp32。
我们不知道的:机理。阈值和现象都有了,但我们没有定位到具体是哪个算子。所以我们把它当成「这个模型在这个运行时上的固有属性」,绕着它设计。
2026-09-22 更新:我们在更新的 ONNX Runtime 上重测了一遍。整张变黑只发生在 JSEP 这个 WebGPU 后端上,也就是我们构建里用的那个,ONNX Runtime 在 1.29 版已经把它弃用了。1.26-dev 和 1.30.0 的 JSEP 都能复现。新的原生 WebGPU 执行提供者(onnxruntime-web/webgpu)在 1.30.0 和 1.31-dev 上,384×384 和 512×384 的输出都正确。如果你遇到类似情况,先换成原生 WebGPU EP 试试,再考虑分块绕开。
我们的做法:工具默认改用一个小巧的卷积模型(Real-ESRGAN general x4v3,4.9 MB),实测在两个后端上一次处理到 1280×960 都正确。Swin2SR 保留为可选的「细节」档,WebGPU 的分块预算定在 320×320,离悬崖留足余量。另外,每个块都要过一道检查:
// session.run() 之后:比较输入与输出的平均亮度
let outSum = 0;
for (let i = 0; i < od.length; i++) outSum += od[i];
const outMean = outSum / od.length;
if (!Number.isFinite(outMean) || Math.abs(outMean - inMean) > 0.05) {
  throw new Error(`bad-output mean ${outMean.toFixed(3)} vs ${inMean.toFixed(3)}`);
}
抛出 bad-output 后,和内存不足一样处理:分块预算减半重试,最多两次。代价只是把输出缓冲区遍历一遍。纯黑图、纯白图、黑底白字的代码截图、高饱和色块都实测过,一次都没误判。
但它并不完备。上表里那段「局部为 0」的过渡区,均值只偏了 0.02 左右,低于阈值。能拦住整张变黑的是均值检查,能避开空洞区的是保守的分块预算,两样缺一不可。
二、从第一个卷积就算错的量化去模糊模型
图片去模糊最初用的是 opencv/deblurring_nafnet:92 MB 的 NAFNet 导出,int8 权重,opset 21。WebAssembly 上结果正确;WebGPU 上,从超分工具沿用过来的自检一上来就报 bad-output mean 5.026 vs 0.413。三档图优化(all、basic、disabled)结果一模一样,所以不是常量折叠的问题。
整个模型从头错到尾时,要找的是「第一个出错的张量」。我们用 onnx.utils.extract_model 在七个中间张量处把图切开,用 onnxruntime-python 在一个固定随机种子的 384×384 输入上算出每一刀的 CPU 参照,再把每个子图放进浏览器跑:
| 切在 | WebGPU 均值 / 标准差 | CPU 均值 / 标准差(WASM 完全一致) |
|---|---|---|
/intro/Conv_output_0 | −0.0329 / 0.311 | −0.0078 / 0.354 |
| 第一个 LayerNorm | −0.0370 / 0.456 | −0.0083 / 0.249 |
| SimpleGate | −0.325 / 2.84 | −0.0317 / 1.86 |
第一个卷积之后就已经错了,再顺着网络往后查没有意义。这个卷积的参数来自两个做分块量化的 DequantizeLinear 节点:权重是形状 [64, 27] 的 int8,block_size: 9, axis: 1;偏置是 64 个值的一维 int8 向量,block_size: 16, axis: 0,一共只有 4 个 scale。
这篇文章最初发布时,我们推测是 WebGPU 内核整体没处理好 block_size。2026-09-22 我们把每个节点单独做成只含一个节点的模型逐一验证,才看清真正的规律:二维的权重反量化在所有后端上都正确,出错的是一维的偏置。第 i 个元素用了第 i 个 scale,像是按逐轴量化处理了,而不是第 i/16 个;第 4 个元素之后,scale 就读越界了。旧的 JSEP 后端和现在的原生 WebGPU EP(1.30.0 与 1.31-dev)表现一样,而且只有带 block_size 的一维输入受影响。我们已用一个 8 个元素的最小复现向 ONNX Runtime 报告:microsoft/onnxruntime#32730。
这个案例留下两条经验:
- 第一个算子就错,先怀疑权重路径,别先怀疑网络结构。大网络出错时,人很容易一头扎进门控、注意力的代码里去找;这次二分直接指向了这一层参数的反量化方式。
- 「Hugging Face 上没有能用的导出」和「这一份导出不能用」是两回事。换一份 NAFNet 导出(
deepghs/image_restoration,fp32,opset 14,275 MB),WebGPU、WebAssembly、CPU 三边输出一致,差异在 2/255 以内;WebGPU 比 WebAssembly 快 5.6 倍,一张 1024×768 的照片分别是 1.95 秒和 10.9 秒。
三、能加载、能打分、但标签互串的 int8 实体识别模型
文本脱敏工具用 GLiNER(gliner_multi_pii-v1)在文本里找人名、邮箱、卡号等。我们先试最小的 int8 导出(333 MB),输入一封 209 词的客服邮件。两个后端都顺利建立会话、返回 logits,没有任何报错。
可输出没法用。WebAssembly 上,置信度最高的实体只有 0.37 分;会员号被标成出生日期,IP 地址也被当成出生日期,银行卡号被当成电话号码。WebGPU 上则是纯噪声:「邮箱地址」这个标签给了一个句号、单词 “it” 和一个逗号。
| 精度 | 体积 | 卡号 | 证件号 | 地址 |
|---|---|---|---|---|
| int8 | 333 MB | 标签互串(WASM)/噪声(WebGPU) | ||
| q4f16 | 450 MB | 0.50 | 0.43 | 0.74 |
| fp16 | 553 MB | 0.88 | 0.76 | 0.97 |
我们最后两条路径都用 fp16。它最大,却是唯一能稳定找出数字类实体的版本,而对脱敏工具来说这恰恰是重点。我们还加了四条正则兜底(邮箱、IPv4、通过 Luhn 校验的卡号、中国大陆手机号),让最危险的漏检不只依赖模型。
还有个小坑:在 WebAssembly 上,fp16 和 q4f16 的图在 graphOptimizationLevel: 'all' 下建不了会话,报一个名为 InsertedPrecisionFreeCast_… 的节点不存在;降到 'basic' 就好,WebGPU 不受影响。所以现在工具配置里,图优化级别是按后端分别声明的。
四、会报错,但报错点指错了节点
这个不算静默,但误导人的方式如出一辙。用于老照片上色的 DDColor-tiny,fp16 导出在 WebGPU 上报:
[WebGPU] Kernel "[MatMul] /decoder/layers.0/shuf/conv/MatMul" failed.
Error: shared dimension does not match.
看名字像卷积,其实这个节点是 spectral_norm 留下的:两个初始化器(weight_u、weight_v)之间的一次 MatMul,算的是一个归一化常数,本该在图到达 GPU 之前就被常量折叠掉。我们只把初始化器和 Cast 节点转成 fp32,其他一概不动,WebGPU 就正常了,与 CPU 参照的相关系数是 1.000000,每张图 0.18 秒,WebAssembly 要 1.5 秒。
我们的解释是:ORT Web 的 CPU 侧没有 fp16 的 MatMul 内核,折叠被跳过,节点漏给了不接受一维操作数的 WebGPU 内核。这是推测,没有证实。不过我们在另一个 fp16 模型上看到过对应的警告:“Could not find a CPU kernel and hence can't constant fold”。无论机理如何,结论是:fp16 导出可能悄悄让常量折叠失效,而报错指向的是后果,不是病因。
fp32 的重转版本我们还没上线,因为部署流程只从 Hugging Face 拉权重,我们还没有托管自己导出的版本。所以上色工具被声明为只走 WebAssembly,即使在网址里加参数强制指定,运行时也会拒绝 WebGPU。
顺带一提:正常报错的那个
Whisper 合并解码器的 q8 量化版,在 WebAssembly 上建会话时报 TransposeDQWeightsForMatMulNBits Missing required scale,onnx-community 和 Xenova 两个仓库的导出都一样。它很烦人,但属于「好的失败」:加载时就知道不行。我们的语音转文字在 WebAssembly 上用的是 fp32 编码器加 q4 解码器。
现在每个工具都会做的事
- 探针看输出对不对,不只看能不能跑。每个候选模型的每种精度,都在两个后端上用真实样例跑一遍,记录能说明输出正确与否的数字:图像看通道均值和零值、NaN 占比,实体识别看标签和分数,能拿到 CPU 结果的就算相关系数。「没抛异常」不算结果。
- 精度从小往大试,但要做好「量化版一个都不能用」的准备。上面四个模型里,能正确工作的最小版本分别是:两个 fp32、一个 fp16、一个本地重转。量化省下了体积,赔上的是正确性或速度。
- 按后端分别声明能力。每个工具的配置里,WebGPU 和 WebAssembly 各自写明精度、图优化级别、分块预算、对齐要求,或者直接写
webgpu: false。同一个 ONNX 文件一个后端能用、另一个不能用,是常态。 - 已知故障模式的,运行时自检。对图生图模型,就是输入输出均值比较,加上自动缩小分块重试,代价只是把已有的缓冲区遍历一遍。
- 用
extract_model加 CPU 参照二分。整个模型都错时,把图切开,逐刀比较均值和标准差;找到第一个出错的张量后,先看它的输入,再看它的邻居。 - 验收在真实浏览器里跑两条路径。上线前,每个工具的内置样例都要在无头 Chrome 里分别走 WebGPU 和 WebAssembly,并通过该工具专属的断言:超分看输出尺寸和亮度,去模糊看清晰度提升,上色看色彩分布且亮度不变,脱敏看必须找出并抹掉的实体。
这些都不需要特殊工具,onnx、Python 版 onnxruntime、Playwright,再加几十行 JavaScript 就够了。真正变的是习惯:session.run() 干净地返回,是测试的开始,不是结束。每个工具的实测速度,我们都公开在工作原理页上。
文中提到的工具: 图片放大 4 倍 · 照片去模糊 · 给文本脱敏:找出并遮盖里面的个人信息 · 给黑白老照片上色 · 录音转文字